
Yapay zekâ projelerinde karşımıza çıkan RAG nedir sorusu, şirket içi dokümanları, PDF’leri veya özel veritabanlarını büyük dil modelleriyle (LLM) entegre etmek isteyenlerin en çok merak ettiği konuların başında geliyor. ChatGPT, Claude veya Llama gibi modeller devasa veri kümeleriyle eğitilmiş olsalar da sizin şirketinizin dünkü satış raporundan, gizlilik sözleşmelerinizden veya henüz yayımlanmamış ürün kataloğunuzdan haberdar değildir. Yapay zekaya veri öğretme ihtiyacı doğduğunda akla ilk gelen yöntem modeli yeniden eğitmek olsa da bu hem son derece maliyetli hem de teknik olarak zor bir süreçtir. İşte bu noktada Bilgi Çekmeyle Desteklenmiş Üretim (Retrieval-Augmented Generation) mimarisi devreye girer.
≡ İçindekiler
Retrieval-Augmented Generation (RAG) Nedir?
RAG, büyük dil modellerinin ürettiği yanıtları, dışarıdaki güvenilir ve güncel bir bilgi kaynağıyla destekleyen bir yapay zekâ mimarisidir. Teknik terimlerin ötesinde bakacak olursak, RAG nedir sorusuna en basit cevabı bir benzetmeyle verebiliriz: Büyük dil modellerini tüm bilgileri ezberlemeye çalışan bir öğrenciye benzetirsek, RAG sistemine sahip bir model sınav esnasında yanında ders kitabını taşıyan ve sadece ilgili sayfayı açıp okuyarak cevap veren bir öğrenci gibidir.
Geleneksel yapay zekâ modelleri sadece eğitim süreçlerinde aldıkları statik bilgilere dayanarak yanıt üretirler. Ancak bu durum iki ana soruna yol açar: Bilgi kesim tarihi (knowledge cutoff) nedeniyle güncel veriye ulaşamama ve modelin emin olmadığı konularda mantıklı görünen fakat tamamen uydurma yanıtlar vermesi (halüsinasyon). Karar destek mekanizmalarında RAG nedir diye düşündüğümüzde, modelin uydurma yanıt verme riskini ortadan kaldıran ve ham veriyi anlamlı yanıtlara dönüştüren köprü olduğunu görürüz.
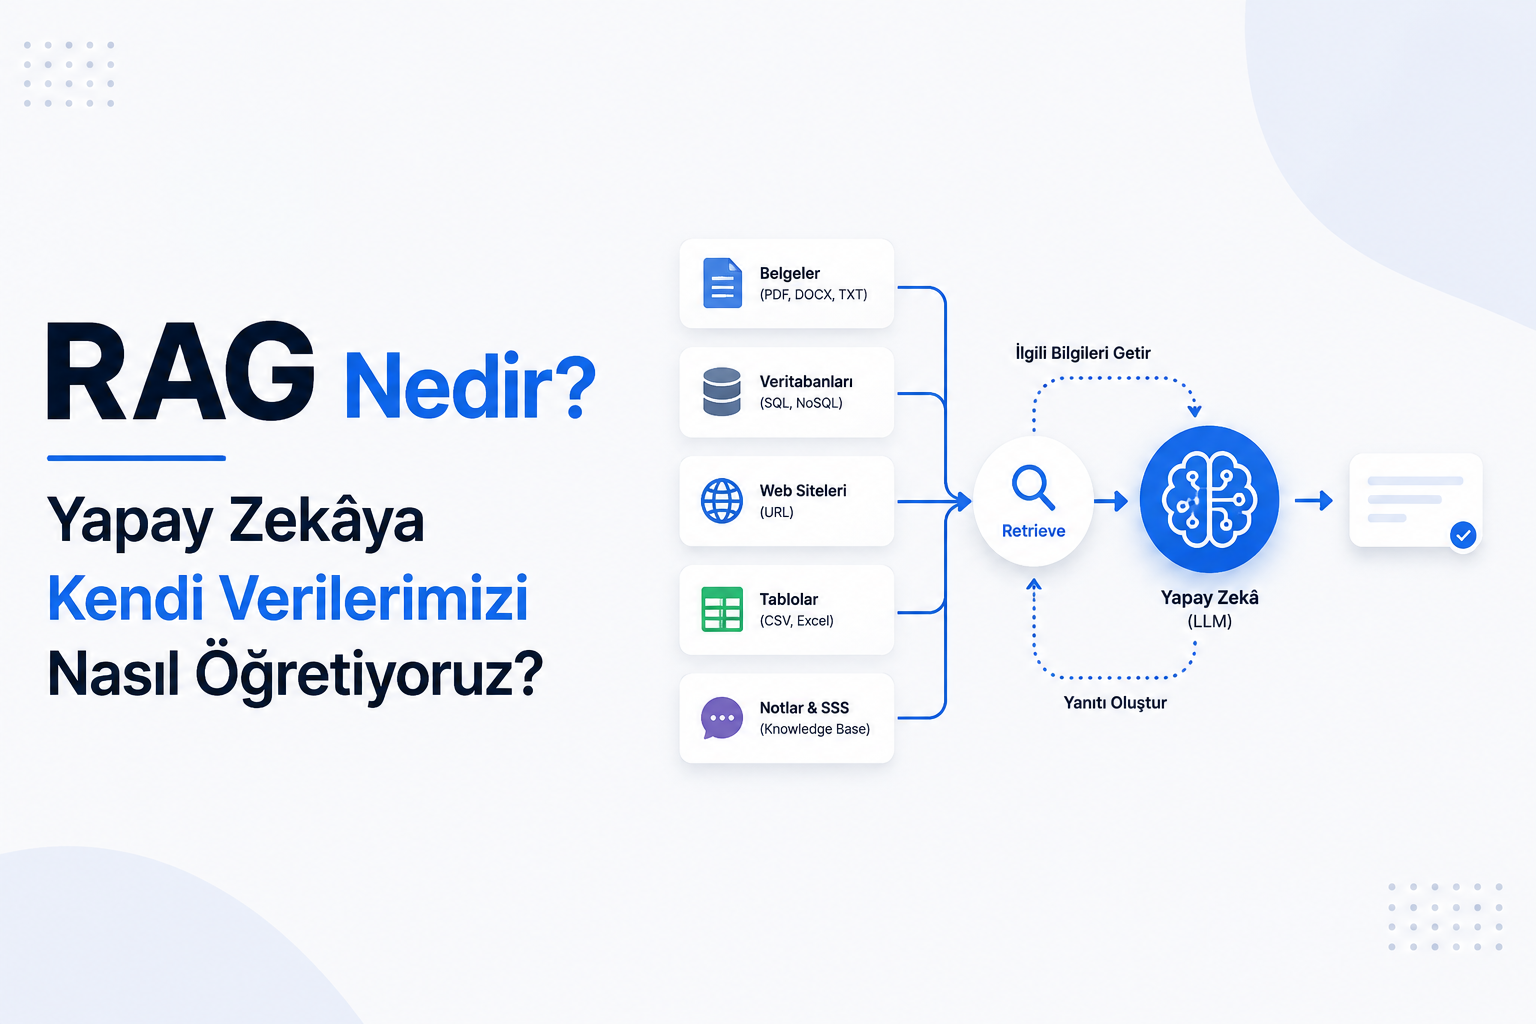
RAG mimarisinde model, kendisine sorulan soruyu yanıtlamadan önce arka planda bir arama yapar. Şirket dokümanlarınız, teknik kılavuzlarınız veya veritabanınız içinde hızlıca bir tarama gerçekleştirir, soruyla en alakalı bilgi parçalarını (chunk) bulur ve bu parçaları ana modele context (bağlam) olarak sunar. Model de kendi dil yeteneğini kullanarak bu sağlanan bağlam üzerinden net, doğru ve kaynağı belli bir yanıt oluşturur.
RAG Mimari Yapısı Nasıl Çalışır?
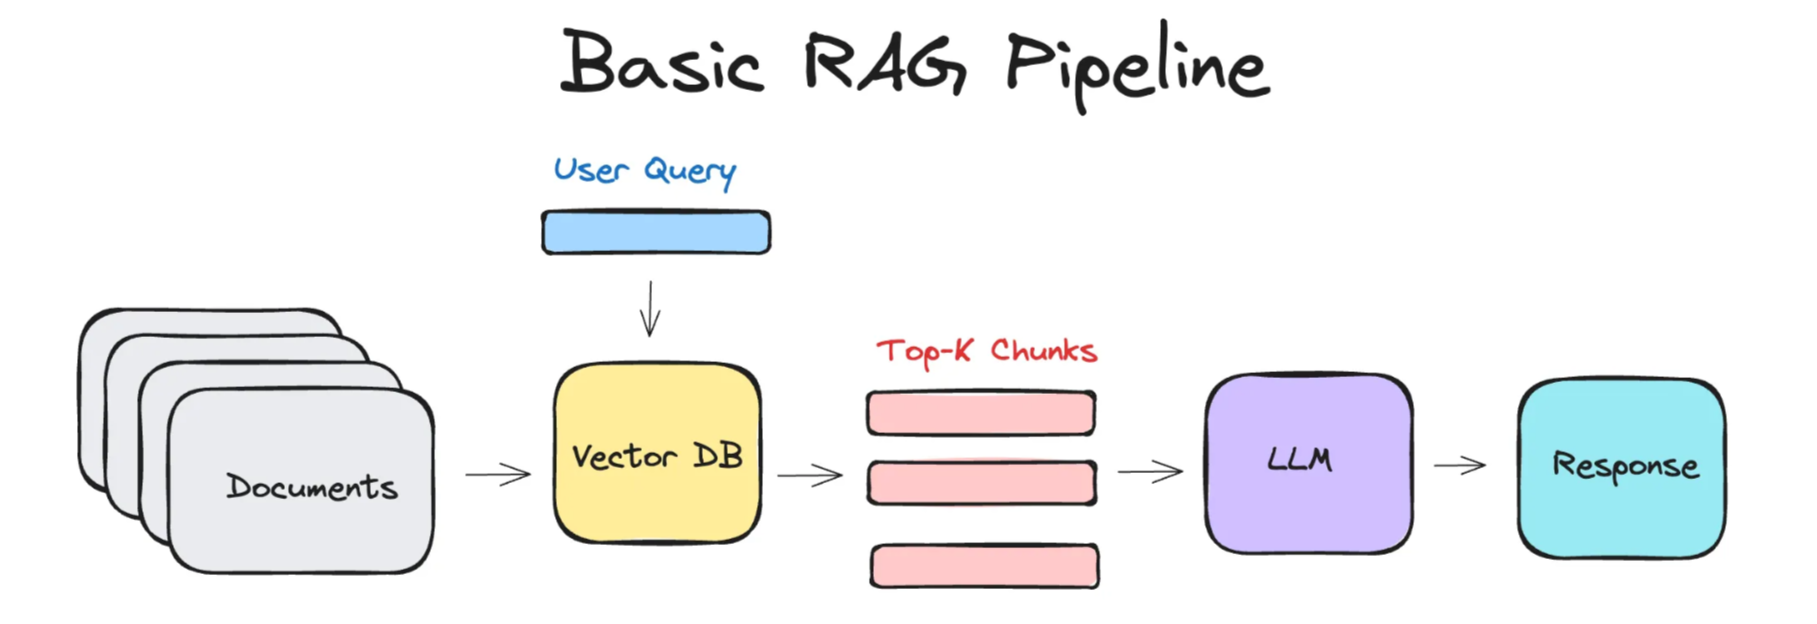
Sistemin arka planındaki mekanizmayı doğru kavramak için RAG nedir konusunu üç ana aşamada incelemek gerekir. Yapı, verinin sisteme dahil edilmesinden kullanıcının ekranına yanıt olarak dönmesine kadar sistematik bir hat (pipeline) üzerinde ilerler.
1. Verilerin Hazırlanması ve Vektörleştirme
İlk adım, yapay zekaya öğretmek istediğiniz metinlerin, dokümanların veya veritabanı kayıtlarının işlenmesidir. PDF dosyaları, Word belgeleri, müşteri destek kayıtları veya web sayfaları gibi farklı formatlardaki veriler öncelikle temizlenir. Ardından bu metinler “chunking” adı verilen işlemle küçük, anlamlı parçalara bölünür. Örneğin 50 sayfalık bir sözleşme, 500’er kelimelik mantıksal bölümlere ayrılır.
Parçalanan bu metinler, gömme modelleri (embedding models) aracılığıyla matematiksel ifadelere, yani vektörlere dönüştürülür. Vektörleştirme işlemi, kelimelerin anlamsal ilişkilerini sayılara döker. Örneğin “araba” ve “otomobil” kelimeleri sayısal uzayda birbirine çok yakın konumlandırılır. Üretilen bu vektörler, hızlı arama yapabilmek amacıyla özel tasarlanmış bir vektör veritabanı (Pinecone, ChromaDB, Milvus, Qdrant gibi) içinde saklanır.
2. İlgili Bilginin Çağrılması (Retrieval)
Kullanıcı sisteme bir soru sorduğunda, örneğin “İzin politikamızda yıllık izin devri nasıl yapılır?” dediğinde, sistem bu soruyu da anlık olarak aynı embedding modeliyle vektöre dönüştürür. Sürecin mantığını çözerken RAG nedir sorusunun yanıtı tam olarak bu arama aşamasında belirginleşir.
Sistem, kullanıcının sorusunun vektörü ile vektör veritabanındaki binlerce metin parçasının vektörünü karşılaştırır (vektör benzerliği araması – cosine similarity). Sorudaki anlama en yakın olan en alakalı 3-5 metin parçası veritabanından çekilir (Retrieval). Böylece tüm kütüphaneyi okumak yerine sadece ilgili sayfalar bulunur.
3. Yanıtın Üretilmesi (Generation)
Son aşamada, kullanıcının orijinal sorusu ile veritabanından çekilen alakalı metin parçaları birleştirilerek yapay zekâ modeline (LLM) bir komut (prompt) olarak gönderilir. Komut yapısı yaklaşık olarak şöyledir:
“Sana verilen şu bilgi parçalarını kullanarak kullanıcının sorusuna cevap ver. Eğer verilen bilgilerde cevabı bulamıyorsan bilmediğini söyle, kendinden bilgi uydurma.”
Büyük dil modeli, kendi devasa dil kuralları ve anlamlandırma becerisini kullanarak bu bilgiyi derler ve kullanıcıya akıcı, doğru, dil bilgisi kurallarına uygun bir yanıt sunar. Süreç tamamen arka planda milisaniyeler içinde gerçekleşir.
RAG ile Fine-Tuning Arasındaki Farklar Nelerdir?
Yapay zekayı kendi verilerinizle çalıştırmak istediğinizde karşınıza iki temel seçenek çıkar: RAG veya Fine-Tuning (İnce Ayar). Şirketlerin ihtiyaçlarını belirleme aşamasında RAG nedir ve Fine-Tuning’den ne kadar farklıdır sorusunu yanıtlamak doğru mimariyi seçmek açısından kritiktir.
Fine-Tuning, mevcut bir dil modelinin tüm ağırlıklarını veya belirli katmanlarını kendi verisetinizle yeniden eğiterek modele yeni bir üslup, format veya uzmanlık kazandırma işlemidir. RAG ise modelin yapısına dokunmadan ona harici bir arama motoru ve bellek ekleme işlemidir.
| Kriter | RAG Mimarisi | Fine-Tuning |
|---|---|---|
| Veri Güncelleme | Anlık. Veritabanına yeni belge eklemek yeterlidir. | Zor. Her veri değişiminde modeli yeniden eğitmek gerekir. |
| Maliyet | Düşük. Sadece vektörleştirme ve sorgu maliyeti vardır. | Yüksek. Güçlü GPU altyapısı ve eğitim bütçesi gerektirir. |
| Halüsinasyon Riski | Çok Düşük. Model sadece sağlanan bağlama dayanır. | Orta/Yüksek. Ezberlenen bilgiyi karıştırabilir. |
| Şeffaflık ve Doğrulama | Yüksek. Cevabın hangi belgeden alındığı gösterilebilir. | Düşük. Bilginin nereden çekildiği tespit edilemez. |
| Kullanım Amacı | Dinamik bilgi, belge analizi, soru-cevap sistemleri. | Modelin üslubunu, formatını veya dilini değiştirme. |
Pratik bir sistem kurarken RAG nedir sorusunun ötesine geçip iki yöntemi birleştiren yapılar da kurgulanabilir. Örneğin, tıbbi terimleri ve üslubu anlaması için Fine-Tuning yapılmış bir modele, güncel hasta kayıtlarını okuması için RAG entegre edilebilir. Ancak çoğu kurumsal projede RAG tek başına yeterli ve çok daha verimlidir.
Neden Şirketler ve Geliştiriciler RAG Kullanmalı?
İş dünyasında LLM özel veri kullanımı ihtiyacı günden güne artıyor. Şirketler kendi fikri mülkiyetlerini korurken yapay zekanın gücünden yararlanmak istiyor. Bu bağlamda RAG nedir ve kurumlara ne gibi avantajlar sağlar sorusunun öne çıkan nedenleri şunlardır:
- Sıfıra Yakın Halüsinasyon: Model, yanıtı üretirken dışarıdan beslendiği için kendi kafasından bilgi uydurmak yerine önüne konan resmi dokümanı baz alır. Doğru yapılandırılmış bir sistemde model, cevabı bulamadığında “Bu konuda elimde bilgi yok” yanıtını verir.
- Kaynak Gösterebilme (Traceability): Verilen yanıtın altına “Bu bilgi Şirket İçi Yönetmelik Madde 4’ten alınmıştır” şeklinde kaynak linki veya sayfa numarası eklenebilir. Bu durum kurumsal güvenilirliği artırır.
- Veri Güvenliği ve Erişim Kontrolü: Şirket verileri genel yapay zekâ modellerinin eğitimine dahil edilmez. Ayrıca kullanıcı yetkilerine göre filtreleme yapılabilir; örneğin bir insan kaynakları personeli maaş skalasını sorgulayabilirken, normal bir çalışan sorduğunda ilgili belge arama sonuçlarına dahil edilmez.
- Düşük Maliyet ve Hızlı Entegrasyon: Modelleri sıfırdan eğitmek veya ince ayar yapmak haftalar sürerken ve binlerce dolar harcamayı gerektirirken, RAG sistemini kurmak ve canlıya almak günler içinde tamamlanabilir.
- Anlık Veri Güncelliği: Şirket politikası değiştiğinde tek yapmanız gereken yeni PDF’i vektör veritabanına yüklemek ve eskisini silmektir. Model anında yeni kurallarla çalışmaya başlar.
RAG Mimarisi Nerelerde Kullanılır?
Kullanım alanlarının çeşitliliği göz önüne alındığında RAG nedir sorusu sektör bazında farklı pratik karşılıklar bulur. Yapay zekaya veri öğretme süreçlerini basitleştirdiği için günümüzde pek çok farklı alanda RAG yapısıyla karşılaşmaktayız.
Müşteri Hizmetleri ve Destek Botları: Klasik, önceden tanımlanmış yanıtlar veren zayıf chatbot’lar yerine, şirketin tüm ürün kullanım kılavuzlarını, SSS sayfalarını ve geçmiş destek biletlerini okumuş akıllı asistanlar oluşturulur. Müşteri karmaşık bir sorun sorduğunda bot, kılavuzdaki doğru bölümü çekerek anında çözüm sunar.
Kurumsal İç Bilgi Asistanları (Knowledge Base): Yüzlerce çalışanı olan şirketlerde insan kaynakları yönetmelikleri, bilişim teknolojileri prosedürleri veya satış stratejileri içinde arama yapmak zor olabilir. Çalışanlar “Şirket aracı talep formu nereden doldurulur?” diye sorduğunda RAG destekli sistem doğrudan ilgili formu ve yapılması gereken adımları getirir.
Hukuk ve Sözleşme Analizi: Hukuk büroları ve kurumsal hukuk departmanları binlerce sayfalık içtihatları, mahkeme kararlarını ve sözleşmeleri sisteme yükler. Avukatlar “Daha önce benzer bir maddeden dolayı tazminat davası kazandık mı?” sorusunu sorarak dakikalar içinde geçmiş davalara atıf yapan özetler alabilir.
Finansal Analiz ve Raporlama: Bilanço dönemlerinde şirketlerin yayımladığı yüzlerce sayfalık finansal raporlar, çeyrek raporları ve analizler vektör veritabanına aktarılır. Analistler “X şirketinin 3. çeyrekteki operasyonel gider artış oranı nedir ve sebebi nasıl açıklanmıştır?” sorusuna saniyeler içinde yanıt bulur.
Gelişmiş RAG (Advanced RAG) Yöntemleri
Temel seviyede RAG nedir anladıktan sonra, bu yapının performansını artırmak için geliştirilen ileri tekniklere bakmak gerekir. Basit bir arama bazen doğru sonuçları getirmeyebilir. Bu nedenle modern mimarilerde şu teknikler kullanılır:
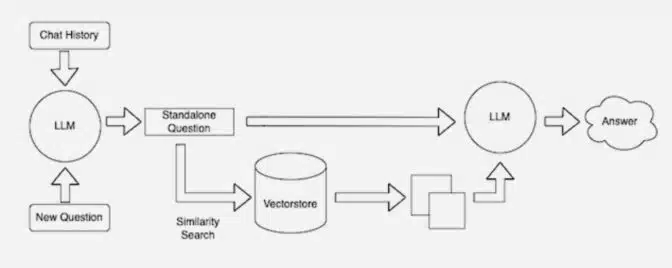
Sorgu Dönüştürme (Query Rewriting): Kullanıcının sorduğu soru her zaman arama yapmak için ideal olmayabilir. Sistem önce kullanıcının sorusunu daha net, detaylı ve arama motorunun anlayacağı bir formata çevirir, ardından arama yapar.
Yeniden Sıralama (Re-ranking): Vektör veritabanından çekilen ilk 20 sonuç, daha hassas bir cross-encoder modeli tarafından tekrar incelenir ve en alakalı ilk 3 sonuç seçilerek dil modeline sunulur. Bu yöntem doğruluk oranını ciddi oranda yükseltir.
Karma Arama (Hybrid Search): Sadece vektör tabanlı anlamsal arama yapmak bazen spesifik ürün kodlarını veya anahtar kelimeleri kaçırabilir. Bu yüzden geleneksel anahtar kelime araması (BM25) ile vektör araması birleştirilerek en optimum sonuç elde edilir.
Kendi yapay zekâ uygulamanızı geliştirirken mimariyi belirlemek, işletmenizin verimliliğini doğrudan etkiler. Doğru bir veri işleme stratejisi ve vektör veritabanı seçimiyle, büyük dil modellerini şirketinizin en değerli uzmanına dönüştürmek son derece kolaydır.